

 +3
Ищете опытную команду интеграторов?
Проанализируем задачи, составим тех. задание и предложим решение.
Что такое машинное обучение: модели и алгоритмы
11 мин
Рассказываем, как алгоритмы учатся на данных, чем машинное обучение отличается от обычного программирования и как подключить его к системам, которыми компания уже пользуется.
Что это такое
Машинное обучение (Machine Learning, ML) – это класс методов ИИ для создания алгоритмов, которые сами находят закономерности в данных и становятся точнее по мере обучения.
Модель учится на примерах: сравнивает свои ответы с правильными, оценивает величину ошибки и шаг за шагом подстраивает внутренние коэффициенты. Обучение повторяется тысячи раз, пока качество на проверочных данных не перестанет расти.
Как это работает
Алгоритм ищет математические зависимости в данных.
Система анализирует исторические данные, находит повторяющиеся закономерности и строит модель, которая предсказывает результат для новых данных. Насколько хорошо это получается, проверяют на примерах, которых модель не видела при обучении.
Чем машинное обучение отличается от программирования
В традиционном программировании инженер вручную закладывает в код алгоритмические правила и подает на вход исходные данные, чтобы получить готовый результат.
В машинном обучении подход меняется на противоположный: в систему загружаются исходные данные вместе с желаемыми результатами, а алгоритм находит между ними связи и сам формулирует математические правила.
| Параметр | Программирование и машинное обучение |
|---|---|
| Входные элементы |
Программирование: данные + правила ML: данные + ответы |
| Результат |
Программирование: результат выполнения правил ML: сформированные правила – модель |
| Изменение логики |
Программирование: разработчик переписывает код ML: модель переобучают на новых данных |
| Сложные закономерности |
Программирование: ограничены тем, что программист может описать ML: модель сама находит связи, которые трудно описать правилами |
Еще три понятия, которые часто путают:
- Искусственный интеллект (ИИ) – вся область, которая занимается системами для задач, обычно требующих человеческого мышления: распознавания речи, принятия решений, диалога
- Машинное обучение (ML) – раздел ИИ, в котором алгоритмы учатся на данных, а не следуют правилам, заданным вручную
- Глубокое обучение (Deep Learning) и нейросети – раздел ML, в котором используются многослойные нейронные сети. Они хорошо работают со звуком, видео и текстом
Искусственный интеллект
| Критерий | Особенности |
|---|---|
| Область охвата | Вся область: системы на правилах, машинное обучение и глубокое обучение |
| Подход | Экспертные системы, правила, алгоритмы поиска; обучение на данных – через ML |
| Данные | Системам на правилах данные для обучения не нужны |
| Вычислительные мощности | У систем на правилах – низкие или средние |
| Правила и признаки | В системах на правилах их задают эксперты вручную |
| Прозрачность решений | У систем на правилах высокая – логика видна |
Машинное обучение
| Критерий | Особенности |
|---|---|
| Область охвата | Практический раздел ИИ |
| Подход | Статистические модели, которые учатся на данных |
| Данные | Нужны исторические данные; для обучения с учителем – с известными ответами |
| Вычислительные мощности | Обычно хватает стандартных серверов |
| Признаки | Подготавливают специалисты по данным (Data Science) |
| Прозрачность решений | Средняя – многие модели можно интерпретировать |
Глубокое обучение
| Критерий | Особенности |
|---|---|
| Область охвата | Раздел машинного обучения |
| Подход | Многослойные нейронные сети |
| Данные | Обычно нужны большие объемы; готовую модель можно дообучить на меньших |
| Вычислительные мощности | Высокие – как правило, нужны графические ускорители (GPU) |
| Признаки | Сеть выделяет сама |
| Прозрачность решений | Низкая – решения трудно объяснить (проблема «черного ящика») |
Из чего состоит ML-решение
Чтобы модель решала задачу бизнеса, важна не только она сама, но и данные, инфраструктура и сопровождение.
ML-решение состоит из четырех частей:
- Данные – сбор, очистка, разметка и хранение информации, формирующие основу для обучения
- Алгоритм – математический метод и набор формул, с помощью которых система находит закономерности в данных
- Модель – итоговый программный объект с зафиксированными коэффициентами, полученный после обучения на датасете
- Инфраструктура и MLOps – подключение к CRM, ERP и другим системам компании, запуск модели в рабочей среде и контроль качества ее прогнозов
Основные понятия, связанные с данными:
- Датасет – набор данных, собранный под конкретную задачу и разделенный на обучающую, валидационную и тестовую выборки
- Обучающая выборка – часть датасета, на которой модель ищет закономерности и подстраивает свои внутренние параметры
- Признаки – количественные и качественные характеристики объектов, выраженные в виде числовых векторов для математической обработки
- Паттерны – устойчивые сочетания признаков, определяющие принадлежность объекта к определенной категории или значение целевой переменной
Типы обучения в прикладных задачах
Выбор метода машинного обучения зависит от характера входных данных и целей автоматизации:
- С учителем (Supervised Learning) – обучение на исторических данных с известными целевыми метками. Применяется для предиктивной аналитики, прогнозирования спроса, оценки оттока клиентов и классификации обращений
- Без учителя (Unsupervised Learning) – модель сама ищет группы и структуру в данных без готовых ответов. Используется для сегментации аудитории и обнаружения аномалий
- С подкреплением (Reinforcement Learning) – обучение агента через взаимодействие со средой методом проб и ошибок. Актуально для узких сценариев автоматизации вроде логистики и динамического ценообразования
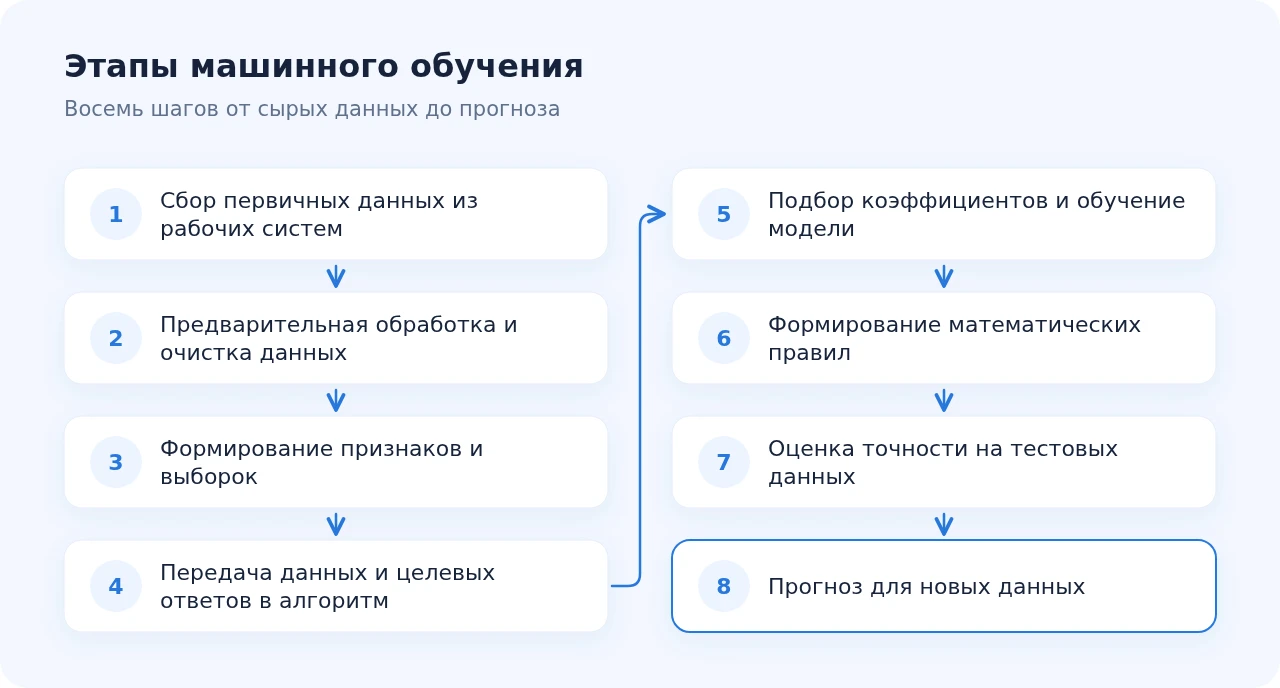
Этапы машинного обучения
- Сбор первичных данных – выгрузка накопленной информации из баз данных, систем учета и внешних источников
- Предварительная обработка – удаление аномалий, заполнение пропусков и приведение форматов к единому виду
- Формирование признаков – выделение наиболее значимых показателей и разделение выборки на обучающую и тестовую
- Передача данных в алгоритм – загрузка подготовленной матрицы признаков и целевых меток в модель
- Обучение модели – многократный подбор коэффициентов и весов, при которых ошибка минимальна
- Формирование правил – фиксация найденных зависимостей в итоговой математической структуре
- Оценка точности – проверка качества работы модели на изолированной тестовой выборке
- Прогноз – применение сформированной модели к свежим рабочим данным
Как подключить ML к системам компании
Чтобы модель приносила пользу, ей нужны качественные данные и связь с рабочими системами компании.
Подготовка данных
Качество прогнозов зависит от данных, на которых учится модель:
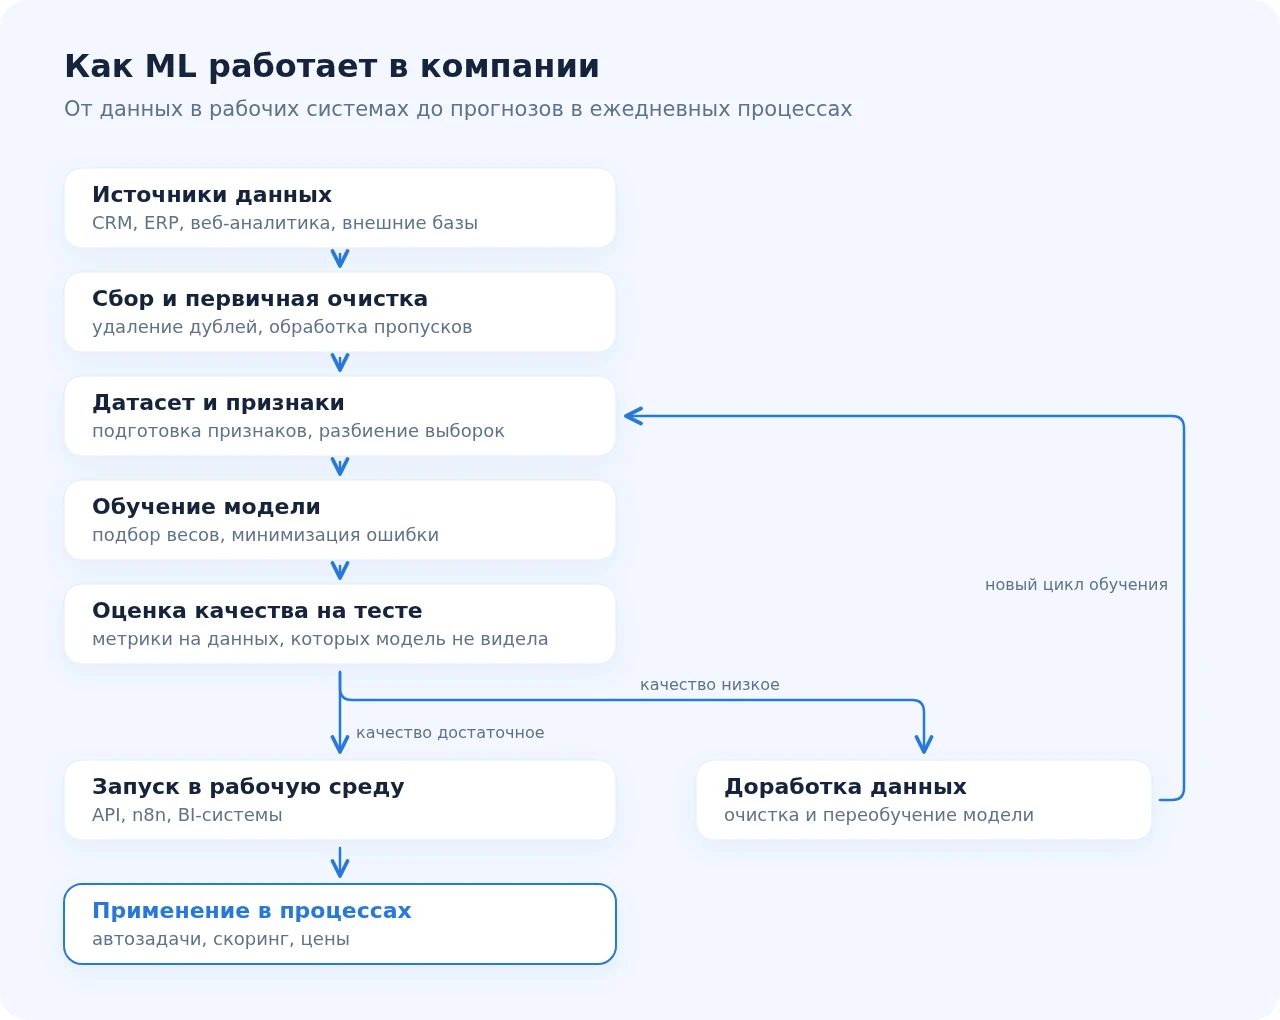
- Источники данных – данные берут из CRM-систем, ERP-платформ, сайта, систем сквозной аналитики и внешних баз
- Проблема «грязных» данных – пропущенные значения, дубликаты и технические ошибки снижают точность модели, поэтому очистка данных (Data Cleaning) часто занимает большую часть времени проекта
Способы внедрения ML-решений
Способ зависит от масштаба бизнеса и того, насколько нестандартна задача:
- Готовые SaaS-сервисы и облачные API – быстрый запуск типовых функций с небольшими стартовыми затратами
- Встроенные модули в корпоративных системах – готовые инструменты в CRM и BI-платформах для решения типовых задач без разработки
- Разработка под заказ – собственная модель для нестандартных процессов, когда готовые решения не дают нужной точности
Связь с рабочими системами
Чтобы прогнозы модели попадали в работу, настраивают:
- Передача данных – обмен между моделью и учетными системами через REST API, брокеры сообщений или n8n
- Обучение сотрудников – прогнозы модели добавляют в регламенты и рабочие интерфейсы, а сотрудников учат ими пользоваться
Свяжем модель с Битрикс24, 1С и другими системами через n8n – данные и прогнозы будут передаваться автоматически.
Интеграция Битрикс24 с любыми системами через n8n
Ниже – общая схема работы ML в компании.
Что дает машинное обучение
- Автоматизация расчетов и прогнозов, которые сложно описать заранее заданными правилами
- Быстрая обработка больших объемов данных о товарах и транзакциях, в том числе по мере их поступления
- Регулярное переобучение модели на новых данных о продажах и складских остатках
- Поиск закономерностей в спросе, которые сложно заметить вручную, когда на продажи влияет сразу много факторов
- Меньше зависимости повседневной работы от субъективных оценок сотрудников
Кейс из практики
Клиент
Региональная производственно-торговая компания с дистрибьюторской сетью на 1500 контрагентов.
Проблема
Задержка обработки входящих заказов менеджерами до 4 часов, регулярный оверсток складов по одним позициям и дефицит по ходовым номенклатурам из-за ручного планирования.
Решение
Внедрение системы машинного обучения для прогнозирования спроса и интеграция модуля автоскоринга входящих спецификаций с CRM-системой через вебхуки n8n.
Результаты внедрения:
- Сокращение времени первичной автоматической проверки и скоринга типовых заявок с 240 минут до 15 секунд
- Снижение объема неликвидных запасов на складах на 28%
- Рост точности выполнения отгрузок точно в срок (OTIF) до 97%
- Высвобождение до 14% оборотного капитала, ранее замороженного в неликвидах, за первые два квартала
Как внедрить машинное обучение в организации?
Внедрение обычно проходит семь этапов:
- Определение приоритетных бизнес-целей и сбор требований от отделов, которые будут пользоваться моделью
- Аудит качества и доступности корпоративных данных в базах компании
- Проведение пилотного проекта (PoC) для подтверждения гипотез и технической выполнимости
- Разработка полноценной архитектуры ML-модели и подготовка инфраструктуры
- Тестирование решения на реальных данных и интеграция в рабочие IT-системы
- Обучение пользователей и запуск системы в постоянную работу
- Мониторинг точности модели в продакшене и ее регулярное переобучение при дрейфе данных
Ограничения и риски
- Низкое качество и разрозненность корпоративных данных в исходных системах хранения
- Нехватка специалистов по данным (Data Science) и высокая стоимость их работы
- Сопротивление персонала изменениям и недоверие к автоматизированным выводам алгоритмов
- Высокие затраты на серверы и вычисления для сложных моделей
- Решения сложных нейросетей трудно объяснить
Зачем нужен интегратор?
Интегратор помогает снизить риски проекта: проверяет данные, подбирает архитектуру и доводит модель до работы в реальных процессах.
Этапы работы интегратора:
- Аудит бизнес-процессов – поиск задач, где алгоритмы принесут наибольшую выгоду
- Проектирование архитектуры – выбор технологий и способов интеграции
- Очистка и подготовка данных – порядок в базах компании, чтобы на них можно было обучать модель
- Разработка и обучение моделей – модели под задачи заказчика
- Настройка обмена данными – связь модели с CRM, ERP и другими системами компании
- Тестирование и валидация – проверка точности на реальных задачах
- Обучение команды – сотрудники учатся работать с прогнозами и новыми отчетами
- Техническое сопровождение – регулярный мониторинг точности и дообучение моделей при изменении данных
Частые вопросы
С чего начать компании, которая никогда не работала с машинным обучением?
Начните с короткого аудита данных и процессов вместе с интегратором. Он поможет выбрать одну задачу для пилотного проекта с понятной окупаемостью.
Как понять, что корпоративные данные в CRM и ERP вообще пригодны для машинного обучения?
Оценить уровень дублей и пропусков своими силами тяжело. Аудит данных от интегратора сразу покажет объем работ по очистке и точность будущих прогнозов.
Можно ли внедрить машинное обучение в старые самописные системы учета без их полной переработки?
Обычно да: модель подключают к текущей системе через REST API, выгрузку данных или n8n, не останавливая работу. Нужно, чтобы система умела отдавать и принимать данные.
Что делать, если сотрудники компании сопротивляются внедрению алгоритмов?
Помогает, когда подсказки модели появляются прямо в привычных интерфейсах сотрудников, например в карточке CRM. Интегратор берет на себя не только код, но и регламенты адаптации.
Как заранее рассчитать экономический эффект и окупаемость внедрения собственной модели?
Показатели окупаемости рассчитываются из экономии часов, оптимизации складов и роста конверсии. Специалист интегратора составит предварительный расчет под вашу нишу.
Что безопаснее для предприятия: использовать готовые облачные API или разрабатывать модель на своих серверах?
Облачные сервисы подходят для типовых задач. Если данные нельзя передавать за пределы компании, модель разворачивают на собственных серверах. В обоих случаях безопасность зависит от прав доступа и условий хранения данных, поэтому архитектуру согласуют со службой безопасности.
Как часто модель машинного обучения требует обслуживания после запуска?
Когда меняется рынок, модели постепенно теряют точность. Для их поддержки нужно регулярное дообучение, которое проще передать интегратору.
Сколько времени занимает путь от первой идеи до работающего ML-решения в компании?
Пилотный проект обычно занимает от 4 до 8 недель, а полное внедрение – несколько месяцев: срок зависит от состояния данных и числа систем.
Заключение
Машинное обучение помогает точнее прогнозировать и быстрее обрабатывать данные – если эти данные собраны и приведены в порядок.
Главный совет перед стартом – начинать с небольших пилотных проектов с понятной метрикой окупаемости инвестиций (ROI), а не пытаться сразу автоматизировать все сложные процессы предприятия.
Оставьте заявку на консультацию, чтобы оценить готовность ваших данных и получить план внедрения ML в вашей компании.
Оценим готовность данных, подберем задачу для пилота и доведем ML-решение до работы в ваших процессах.
Разработка и интеграция ИИ-решений
Расскажем детали внедрения с Live-демонстрацией готового портала
Оставьте заявку и наши специалисты с вами свяжется


Вам также может быть интересно

modal1 content
modal2 content

Спасибо!
Форма успешно отправлена
Наши специалисты скоро свяжутся с вами

Ошибка!
Данные не отправлены
Проверьте правильность заполнения и повторите попытку
Обсудить проект
Оставьте заявку и получите индивидуальное решение по вашей задаче с этапами и сроками производства
Получите бесплатно анализ бизнес-процессов
Проведем бесплатно анализ бизес-процессов, выявим узкие места и разработаем кастомное решение для улучшения показтелей
Купить лицензию
Оставьте заявку и получите индивидуальное решение по вашей задаче с этапами и сроками производства
Ищите опытную команду интеграторов
Проанализируем задачи, составим тех. задание и предложим решение.
Live-демонстрация портала
Продемонстрируем работу портала в реальном времени, ответим на все вопросы
Пригласить на участие в тендере
Пришлем информацию с кейсами по вашей отрасли
Выберите свой город